Začněme nejdříve popisem toho, jak funguje komprese zvuku. Zvukový záznam je ve své podstatě obrovské množství čísel. Mikrofon převádí zvukové vlnění na elektrický signál a ten se při digitálním záznamu vzorkuje – například 44 100krát za sekundu. Každý vzorek je uložen jako číselná hodnota. U stereo záznamu tedy vzniká obrovské množství dat, která je potřeba někam uložit nebo přenášet. Kam tím mířím?
Komprese zvuku je způsob, jak toto množství dat zmenšit. Existují dva základní přístupy. Při bezztrátové kompresi se data pouze efektivněji zapíší, ale při dekompresi dostaneme přesně původní záznam. Typickým příkladem je FLAC. U ztrátové komprese, například MP3 nebo AAC, se naopak některé informace odstraní. Algoritmus se snaží odstranit především takové části zvukové informace, jejichž ztrátu člověk při poslechu příliš nevnímá. Výsledkem je výrazně menší soubor, ovšem za cenu určité ztráty původní informace.
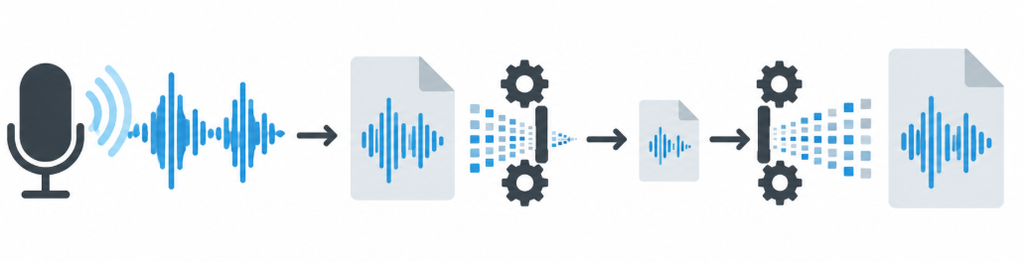
A právě tady se dostáváme k praktickému problému s přepisem rozhovorů. Pokud máme například hodinový rozhovor, nemusíme pro jeho transkripci posílat do služby celou nahrávku v původní kvalitě ani studiovou kvalitu. Můžeme použít i horší záznam, ale pořád dostatečně kvalitní. ElevenLabs a další podobné služby mají omezení na počet kreditů nebo délky nahrávky, kterou do nich můžete v rámci různých předplatných (nebo free verzí) vložit a nechat si zpracovat. Co když ale rozdělíme naše audio soubory na menší části a ty budeme zpracovávat jednu po druhé?
Éra vlastního softwaru
Ještě před několika lety by vytvoření podobného nástroje znamenalo znát programovací jazyk, pracovat s multimediálními formáty a orientovat se v knihovnách pro zpracování zvuku. Dnes je situace výrazně jiná. Pomocí generativní AI si můžeme nechat napsat malý program, který přesně provede operace, které potřebujeme. Nemusíme přitom vytvářet nový projekt na několik týdnů ani rozumět všem detailům zpracování zvuku. Stačí poměrně přesně popsat, co má program udělat.
Pro náš případ tedy můžeme vytvořit jednoduchý program, který vezme dlouhý zvukový soubor, rozdělí ho například na desetiminutové úseky a každý z nich uloží jako samostatný soubor. Ty pak můžeme postupně nahrát do transkripční služby. Nemusíme tak řešit, že původní hodinová nahrávka překračuje limit služby. Bude tedy stačit specifikovat AI pomocí promptu, co chceme udělat a počkat si na výsledek.V našem případě si vystačíme s jednoduchou HTML stránkou s JavaScriptem, která dokáže naše nahrávky rozdělit na několik menších částí přímo v počítači. Data tak není nutné nikam nahrávat ani posílat do cloudu.
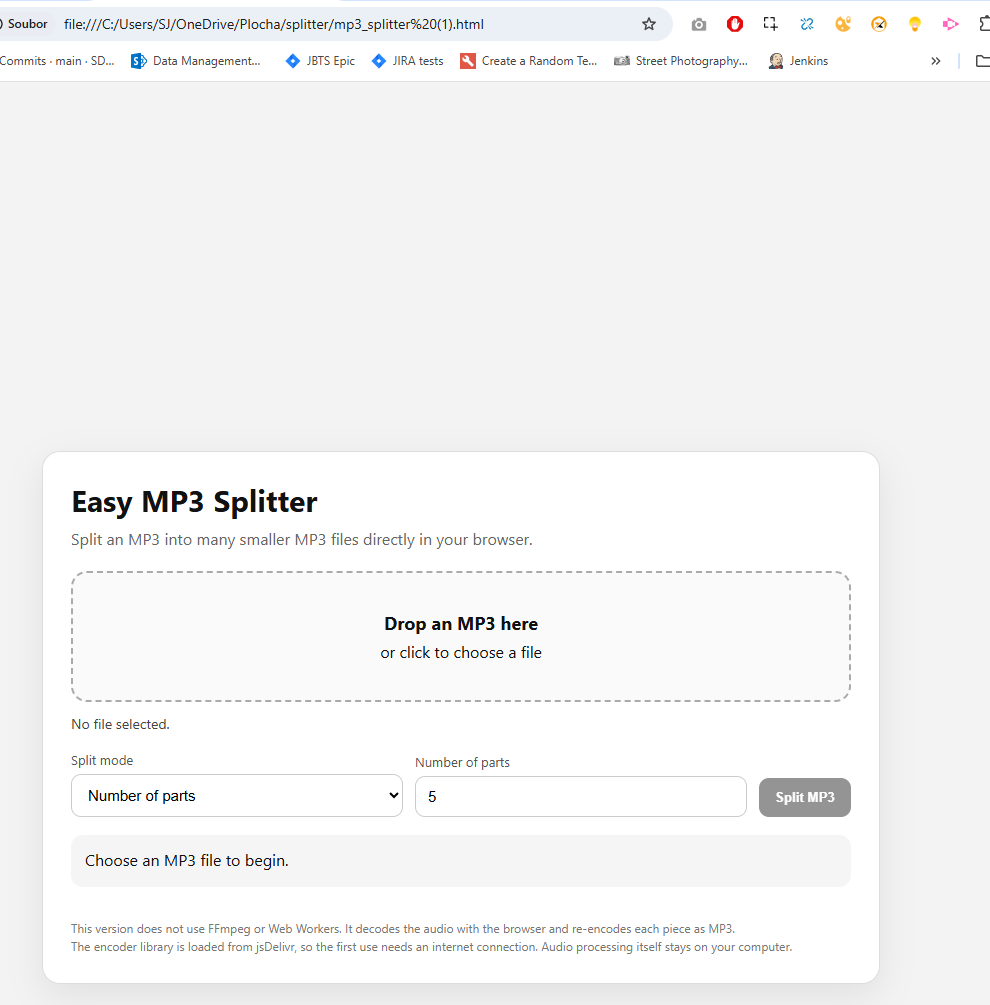
Já si takto například udělal jednoduchou webovou aplikaci, která nahraný soubor během několika málo minut (v závislosti na velikosti souboru) dokáže rozdělit na určitý počet částí. Tyto nahrávky pak samotná AI zpracuje podstatně lépe, než jeden velký soubor a ještě si tak můžete bez problémů otestovat, která služba vám nakonec bude nejlépe vyhovovat.
Na závěr ještě malý přehled aktuálně asi nejlepších nástrojů na přepis rozhovoru:
- ElevenLabs
- Google AI Studio
- Whisper
- TurboScribe